从原始数据中提取模式的能力,叫做 深度学习
逻辑回归 是否剖腹产
朴素贝叶斯 垃圾邮件分类
简单的机器学习算法依赖给定数据的表示,对表示的依赖是普遍现象
统计学的衍生物
问题:对特征难以提取
途径:使用机器学习发掘表示本身 不仅仅把表示映射到输出
什么:representation learning 表示学习
例子:自编码器 autocoder
原理:数据经过编码器和解码器尽可能多的保留信息,同时新的表示有各种特征好的信息
问题:从原始数据提取高复杂度、抽象的特征是非常困难
深度学习 deep learning
通过简单的表示来表达复杂的表示,解决表示学习中的核心问题
可见层 输入层
隐藏层
输出层
图片识别:像素点->边->角->形状->物体
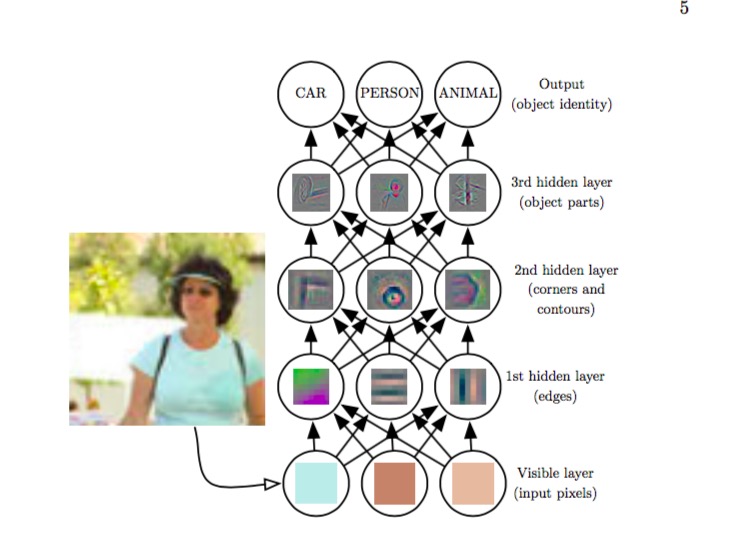
多层感知机 = MLP = multilayer perceptron = 前馈深度网络 = 普通神经网络 变差因素 factors of variation 能够解释数据集的因素
正则化 优化器 cnn卷积神经网络 rnn 循环神经网络
简单线性模型
第一波神经网络研究浪潮==>控制论
联结主义
人工神经网络
自适应线性单元 adaptive linear element ADALINE
随机梯度下降 stochastic gradient descent
线性模型 基于感知机和adaline使用的函数f(x,w)的模型
并行分布处理
长短期记忆 LSTM long-shot term memory 机器翻译
深度玻尔兹曼感知机
语音识别的循环神经网络
强化学习 reinforcement learning 一个自主的智能体在没有人类操作的情况下,通过不断试错来学习执行任务。
theano pylearn2 torch distBelief caffe mxNet tensorflow
标量 scalar 单独的数
向量 vector 一列数
矩阵 matrix 二维数组
张量 tensor 一个数组元素分布在若干维坐标的规则网络中,n维数组
单位矩阵 identity matrix 主对角线的元素都是1,其他位都是0的矩阵
逆矩阵 AB = I B是A的逆矩阵
范数 将向量映射到非负值的函数
f(x)=0 => x=0
f(x+y)<=f(x)+f(y)
f(ax) = |a|f(x)
最大范数 max norm
对角矩阵 只有主对角线上含有非零元素,其他位置都是0
单位向量 是具有单位范数的向量
A*B = 0 相互正交
‘
正交矩阵 行向量和列向量是分别标准正交的矩阵
特征分解 特征向量 特征值
正定矩阵 所有特征值是正数
半正定矩阵 所有特征值是非负数
生成子空间
线性相关 linear dependence
方阵 square
奇异的 singular
对角矩阵 diagonal matrix
对称矩阵
单位向量 unit vector 单位范数 unit norm
正交矩阵
特征分解 矩阵分解成一组特征向量和特征值
奇异值分解 singular value decoposition ( SVD ) 奇异向量 奇异值
伪逆 Ax = y
主成分分析 PCA principal components analysis
不确定性:
1.被建模系统内在的随机性
2.不完全观测
3.不完全建模
信任度
频率派概率
贝叶斯概率
随机变量 离散随机变量 连续随机变量
概率分布 一簇随机变量取到状态的可能性大小
归一化
均匀分布
联合概率分布
概率质量函数 PMF 概率密度函数PDF
边缘概率分布 一组联合概率分布的子集概率分布
求和法则
条件概率 事件在其他事件发生下出现的概率
链式法则 乘法法则
独立性 条件独立性
p(x=x,y-y|z=z) x,y在给定的z条件下是独立的
f(x)关于某分布P(x)的期望或者期望值 P(x)f(x)平均值
协方差矩阵
相关系数
bernoulli分布 二值分布 [0,1]
范畴分布 多项式分布 multinoulli
高斯分布 == 正态分布 中心极限定理 多维正态分布
指数分布 laplace分布
高斯混合模型 先验分布 后验分布
贝叶斯规则
香农熵
交叉熵
信息论 一个不太可能的事情发生比一个非常有可能的事情发生有更多的信息
结构化概率模型 图模型
图 通过边互相连接的顶点的集合构成
有向图
无向图
下溢 上溢
softmax函数
病态条件
目标函数
代价函数 损失函数 误差函数
梯度 相对一个向量求导的导数
梯度下降
爬山算法
约束优化
最大似然估计
最大后验估计
激励函数
马尔科夫随机场
我们关于过去的知识丝毫不影响这种决定性。这种在已知 “现在”的条件下,“未来”与“过去”彼此独立的特性就被称为马尔科夫性
一只被切除了大脑的白鼠在若干个洞穴间的蹿动就构成一个马尔可夫链。瞬时记忆
生成对抗网络
在强化学习中,一个自主的智能体必须在没有人类操作者指导的情况下,通 过试错来学习执行任务
一 线性代数
L2范数 欧几里得范数
对角矩阵 D 对角线上的元素被称为矩阵 A 的 奇异值(singular value)
PCA SVD
二 概率论
随机变量 概率分布
离散型变量 概率质量函数
连续型变量 概率密度函数
边缘概率 条件概率 链式法则 乘法法则
独立性 条件独立性 期望 方差 协方差
分布: Bernoulli 分布 Multinoulli 分布 多项式分布 高斯分布 正态分布 标准正态分布
中心极限定理 指数分布 Laplace分布 Dirac分布 经验分布 潜变量 高斯混合模型
函数:
logistic sigmoid 函数
softplus函数
贝叶斯规则
测度论
jacobian矩阵
三 信息论:
自信息 香农熵 KL散度 交叉熵
结构化概率模型 图模型 有向 无向
四 数值计算
上溢 下溢 softmax 病态条件 梯度下降 学习率 Jacobian 和 Hessian 矩阵
Lipschitz 连续
凸优化 约束优化
Karush–Kuhn–Tucker(KKT)方法
广义 Lagrange 函数
线性最小二乘
五 机器学习基础
任务:分类 输入缺失分类 回归 转录 机器翻译 结构化输出 异常检测 合成采样 缺失值填补 去噪 密度估计 概率质量函数估计 VC维度 权重衰减 K折验证 点估计 最大似然估计 条件对数似然和均方误差
最大后验估计MAP
深度学习发展动机的一部分原因是传统学习算法在这类人工智能问题上泛化能
力不足。
维数灾难 局部不变性和平滑正则化
六 深度学习
前馈神经网络
整流线性单元及其扩展
logistic sigmoid与双曲正切函数
径向基函数(radial basis function, RBF)
softplus函数
硬双曲正切函数(hard tanh)
实际上, 反向传播仅指用于计算梯度的方法
正则化
在机器学习中,许多策略显式地被设计来减少测试误差(可能会 以增大训练误差为代价)。这些策略被统称为正则化
参数范数惩罚
Bagging(bootstrap aggregating)是通过结合几个模型降低泛化误差的技术
模型平均(model averaging)。采用这种策略的技术被称为集成方法
dropout
病态 局部最小值 高原鞍点和平坦区域
长期依赖 梯度消失 梯度爆炸
adam
rmsprop
sgd
AdaGrad
Nesterov
动量
坐标下降
Polyak 平均
延拓法(continuation method)
卷积网络是指那些至少在网络的一层中使用卷积运算来 替代一般的矩阵乘法运算的神经网络
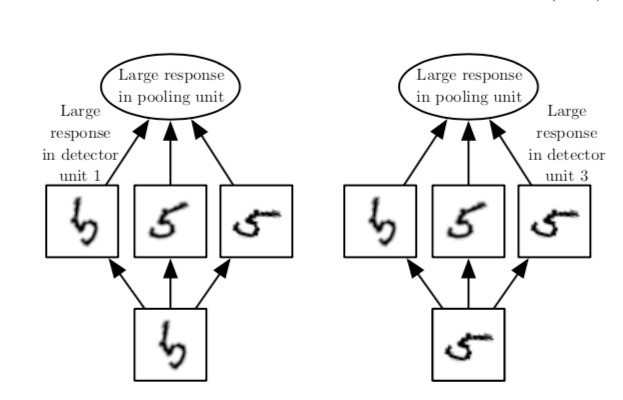
池化 平移不变性
XOR异或